Long-read Sequencing چیست؟ کشف رازهای پنهان ژنوم با فناوری توالی یابی خوانش بلند

Long-read Sequencing چیست و چرا اهمیت دارد؟
با پیشرفت فناوریهای ژنتیک مولکولی، دانشمندان توانستهاند اطلاعات ژنتیکی موجود در DNA و RNA را با سرعت و دقت بیشتری بررسی کنند. یکی از فناوریهای مهم در این حوزه Long-read Sequencing یا توالییابی خوانش بلند است؛ روشی که امکان خواندن قطعات طولانیتری از اسیدهای نوکلئیک را فراهم میکند و به پژوهشگران کمک میکند ساختار ژنوم را با جزئیات بیشتری بررسی کنند.
فناوریهای متداول توالییابی نسل جدید (NGS) معمولاً قطعات کوتاهتری از DNA را میخوانند. این روشها در بسیاری از پروژهها کارآمد هستند، اما بررسی برخی نواحی پیچیده ژنوم، توالیهای تکراری، تغییرات ساختاری بزرگ و ایزوفرمهای مختلف RNA با خوانشهای کوتاه میتواند دشوار باشد.
در چنین شرایطی، Long-read Sequencing با تولید خوانشهای طولانیتر، اطلاعاتی را در اختیار پژوهشگران قرار میدهد که ممکن است در روشهای مبتنی بر خوانش کوتاه بهسادگی قابل دستیابی نباشند.
Long-read Sequencing چیست؟
توالییابی خوانش بلند یکی از فناوریهای تعیین توالی DNA و RNA است که میتواند قطعاتی با طول چندین هزار تا دهها هزار نوکلئوتید و در برخی پلتفرمها حتی طولانیتر را در یک خوانش ثبت کند.
منظور از خوانش (Read)، توالیای است که دستگاه توالییاب از یک مولکول DNA یا RNA یا از نسخهای از آن ثبت میکند. طول خوانش اهمیت زیادی دارد؛ زیرا مشخص میکند چه مقدار از اطلاعات توالی در یک قطعه قابل مشاهده است.
دو فناوری شناختهشده در این زمینه عبارتاند از:
- PacBio SMRT Sequencing: فناوری مبتنی بر مشاهده سنتز DNA در زمان واقعی.
- Oxford Nanopore Sequencing: فناوری مبتنی بر اندازهگیری تغییرات سیگنال الکتریکی هنگام عبور مولکول اسید نوکلئیک از یک نانوحفره.
فناوری Long-read Sequencing چگونه کار میکند؟
۱. استخراج DNA یا RNA
در نخستین مرحله، اسید نوکلئیک از نمونه زیستی استخراج میشود. این نمونه میتواند خون، بافت، سلول، نمونه میکروبی یا ماده زیستی دیگری باشد که برای هدف پژوهش مناسب است.
در توالییابی خوانش بلند، کیفیت استخراج اهمیت ویژهای دارد. DNA باید تا حد امکان سالم و دارای قطعات بلند باشد؛ زیرا شکستهشدن DNA میتواند طول خوانشهای نهایی را کاهش دهد.
۲. آمادهسازی کتابخانه توالییابی (Library Preparation)
پس از استخراج، نمونه برای ورود به دستگاه توالییاب آماده میشود. این مرحله ممکن است شامل اصلاح انتهای مولکولها و اتصال آداپتورها باشد. جزئیات کار به پلتفرم انتخابشده بستگی دارد.
۳. خواندن توالی DNA یا RNA
در فناوری PacBio SMRT، فعالیت آنزیم پلیمراز هنگام افزودن نوکلئوتیدها به رشته در حال سنتز مشاهده میشود. در فناوری PacBio HiFi، اطلاعات حاصل از خواندن چندباره یک مولکول الگوی حلقوی برای تولید توالی اجماعی با دقت بالا استفاده میشود.
در فناوری Oxford Nanopore، عبور DNA یا RNA از یک نانوحفره باعث تغییر سیگنال الکتریکی میشود. دستگاه این سیگنالها را ثبت میکند و الگوریتمهای محاسباتی، توالی نوکلئوتیدها را از روی آنها استنباط میکنند.
۴. تحلیل بیوانفورماتیکی دادهها
دادههای خام باید پردازش و تحلیل شوند تا اطلاعات زیستی قابل استفاده به دست آید. این مرحله میتواند شامل کنترل کیفیت، همترازی با ژنوم مرجع، شناسایی واریانتها، مونتاژ ژنوم یا بررسی رونوشتهای RNA باشد.

تفاوت Long-read Sequencing و Short-read Sequencing چیست؟
تفاوت اصلی این دو فناوری در طول خوانش، نوع اطلاعات قابل بازیابی و کاربردهای آنهاست.
|
ویژگی |
Long-read Sequencing | Short-read Sequencing |
|
طول خوانش |
معمولاً چند هزار نوکلئوتید یا بیشتر |
اغلب حدود ۵۰ تا ۳۰۰ نوکلئوتید |
|
بررسی نواحی تکراری |
معمولاً توانایی بیشتری در عبور از تکرارهای بلند دارد | ممکن است در نواحی پیچیده با ابهام روبهرو شود |
|
شناسایی تغییرات ساختاری |
برای بسیاری از تغییرات بزرگ مناسب است |
برخی تغییرات پیچیده دشوارتر شناسایی میشوند |
|
مونتاژ ژنوم |
معمولاً امکان مونتاژ پیوستهتر را فراهم میکند |
ممکن است در برخی نواحی شکافهای بیشتری ایجاد شود |
|
بررسی ایزوفرمهای RNA |
امکان خواندن بخش بزرگی از رونوشت یا رونوشت کامل را فراهم میکند |
اغلب به بازسازی محاسباتی رونوشتها نیاز دارد |
|
هزینه و زیرساخت |
وابسته به پلتفرم و پروژه |
برای بسیاری از پروژههای پرظرفیت، اقتصادی است |
هیچکدام از این دو روش در تمام کاربردها برتر نیستند. Short-read Sequencing همچنان برای بسیاری از مطالعات بیان ژن، توالییابی کل اگزوم و پروژههای پرظرفیت گزینهای کارآمد است؛ در مقابل، Long-read Sequencing برای حل برخی پیچیدگیهای ساختاری ژنوم مزیت ویژهای دارد.
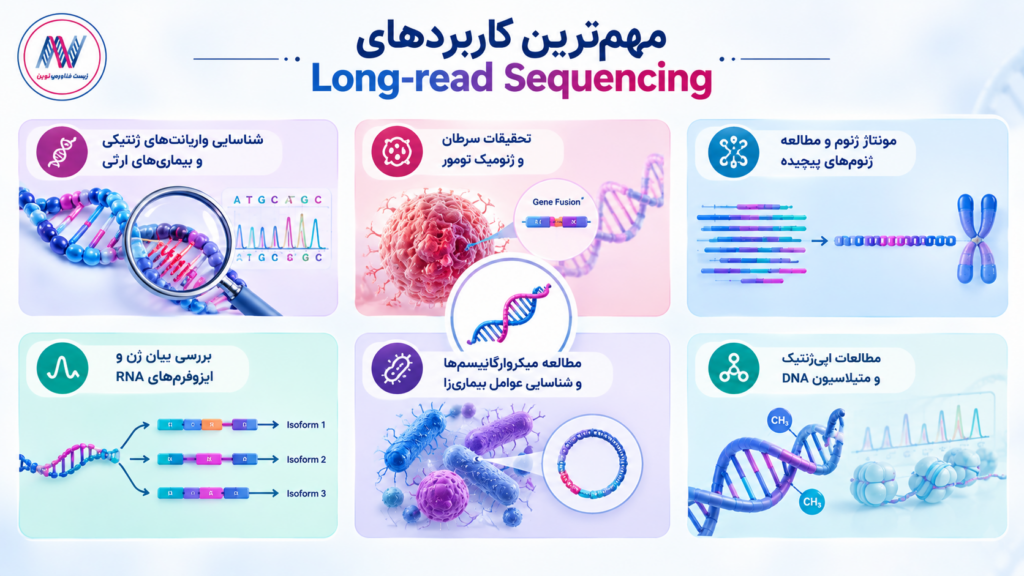
مهمترین کاربردهای Long-read Sequencing
۱. شناسایی واریانتهای ژنتیکی و بیماریهای ارثی
بیماریهای ژنتیکی همیشه ناشی از تغییر یک نوکلئوتید نیستند. حذف یا اضافهشدن قطعات بزرگ DNA، وارونگی بخشهایی از کروموزوم و گسترش تکرارهای ژنتیکی نیز میتوانند در بروز بیماری نقش داشته باشند.
Long-read Sequencing میتواند در شناسایی این تغییرات ساختاری و بررسی نواحی دشوار ژنوم کمککننده باشد. همچنین، خوانشهای بلند امکان بررسی ارتباط میان چند واریانت در یک مولکول DNA را فراهم میکنند؛ موضوعی که در تعیین فاز هاپلوتیپی (Haplotype Phasing) اهمیت دارد.
۲. تحقیقات سرطان و ژنومیک تومور
سرطان تنها به جهشهای کوچک در ژنها محدود نمیشود. تغییرات ساختاری بزرگ، جابهجایی قطعات کروموزومی و ایجاد ژنهای ترکیبی یا فیوژن (Gene Fusion) نیز میتوانند در ایجاد یا پیشرفت برخی سرطانها نقش داشته باشند.
توالییابی خوانش بلند به پژوهشگران کمک میکند این تغییرات را در بستر وسیعتری از ژنوم بررسی کنند.
کاربردهای پژوهشی این فناوری در سرطان شامل موارد زیر است:
- بررسی تغییرات ساختاری پیچیده در ژنوم سلولهای سرطانی
- شناسایی برخی ژنهای فیوژن و نقاط شکست کروموزومی
- مطالعه ناهمگنی ژنتیکی تومورها
- بررسی تغییرات متیلاسیون DNA در پلتفرمهای مناسب
- تحلیل رونوشتها و الگوهای پیرایش جایگزین در سلولهای سرطانی
بااینحال، Long-read Sequencing بهتنهایی جایگزین تمام آزمایشهای تشخیص سرطان نیست و نتایج آن باید متناسب با کاربرد مورد نظر تفسیر شوند.
۳. مونتاژ ژنوم و مطالعه ژنومهای پیچیده
مونتاژ ژنوم (Genome Assembly) به فرایند بازسازی توالی ژنوم از قطعات توالییابیشده گفته میشود. در ژنومهایی که توالیهای تکراری بلند دارند، خوانشهای کوتاه ممکن است نتوانند مشخص کنند هر قطعه متعلق به کدام بخش ژنوم است.
خوانشهای بلند با عبور از نواحی تکراری و اتصال بخشهای مجاور به یکدیگر، میتوانند مونتاژ پیوستهتر و کاملتری ایجاد کنند. این قابلیت در مطالعه ژنوم انسان، گیاهان، جانوران و میکروارگانیسمها اهمیت دارد.
۴. بررسی بیان ژن و ایزوفرمهای RNA
یک ژن ممکن است از طریق پیرایش جایگزین (Alternative Splicing) چند رونوشت متفاوت تولید کند. این رونوشتها میتوانند از نظر ترکیب اگزونها متفاوت باشند و در شرایط زیستی مختلف نقشهای متفاوتی داشته باشند.
در RNA-seq مبتنی بر خوانش کوتاه، پژوهشگر معمولاً باید قطعات کوچک RNA را با روشهای محاسباتی کنار هم قرار دهد تا ساختار رونوشتها را بازسازی کند. در مقابل، توالییابی خوانش بلند RNA یا cDNA امکان مشاهده بخش بزرگی از یک رونوشت و در شرایط مناسب کل رونوشت را فراهم میکند.
این قابلیت در پژوهشهای سرطان، زیستشناسی سلولی، تنظیم بیان ژن و بررسی پاسخ سلول به شرایط محیطی اهمیت دارد.
۵. مطالعه میکروارگانیسمها و شناسایی عوامل بیماریزا
در میکروبشناسی و زیستشناسی مولکولی، Long-read Sequencing میتواند برای بررسی ژنوم باکتریها، شناسایی سویهها و مطالعه عناصر ژنتیکی متحرک مانند پلاسمیدها به کار رود.
برای مثال، برخی ژنهای مرتبط با مقاومت آنتیبیوتیکی روی پلاسمیدها قرار دارند. خوانشهای بلند میتوانند به مشخصشدن ارتباط این ژنها با عناصر ژنتیکی اطرافشان کمک کنند.
این فناوری همچنین در مونتاژ ژنوم میکروبی، بررسی تنوع ژنتیکی پاتوژنها و پژوهشهای اپیدمیولوژیک کاربرد دارد. با این حال، شناسایی یک ژن مقاومت بهتنهایی همیشه به معنای اثبات مقاومت فنوتیپی نیست.
۶. مطالعات اپیژنتیک و متیلاسیون DNA
تغییرات اپیژنتیکی، از جمله متیلاسیون DNA، میتوانند بر تنظیم فعالیت ژنها تأثیر بگذارند، بدون آنکه لزوماً توالی اصلی DNA تغییر کند.
برخی پلتفرمهای توالییابی خوانش بلند قادرند با تحلیل سیگنالهای حاصل از مولکولهای DNA، اطلاعاتی درباره تعدادی از تغییرات شیمیایی بازها به دست آورند.
ترکیب دادههای ژنومی و اپیژنتیکی میتواند در پژوهشهای مربوط به تنظیم بیان ژن، تمایز سلولی و سرطان مفید باشد.
مزایای Long-read Sequencing چیست؟
مهمترین مزیت توالییابی خوانش بلند، افزایش اطلاعات زمینهای هر خوانش است. در بسیاری از کاربردها، دانستن ترتیب نوکلئوتیدها کافی نیست؛ پژوهشگر باید بداند بخشهای مختلف DNA چگونه در کنار هم قرار گرفتهاند.
مهمترین مزایای این فناوری عبارتاند از:
- بررسی بهتر نواحی پیچیده ژنوم و بسیاری از توالیهای تکراری
- شناسایی بهتر برخی تغییرات ساختاری بزرگ
- کمک به تولید مونتاژ پیوستهتر ژنوم
- تحلیل ایزوفرمهای RNA و رونوشتهای بلند
- بررسی فاز هاپلوتیپی و ارتباط میان واریانتها
- بررسی برخی تغییرات اپیژنتیکی در پلتفرمهای مناسب
میزان بهرهمندی از هر مزیت به نوع فناوری، کیفیت نمونه، پوشش توالییابی و روش تحلیل وابسته است.
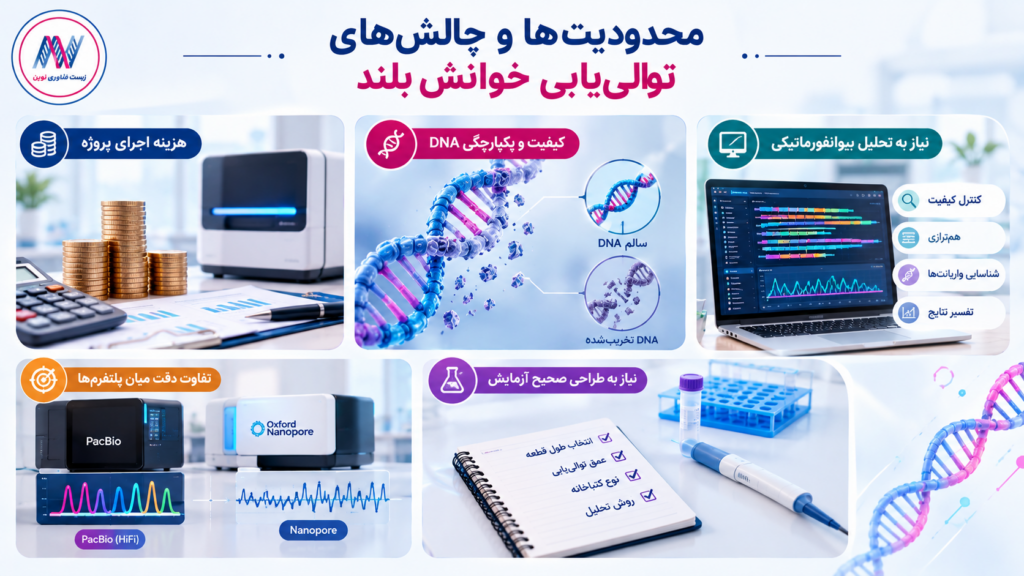
محدودیتها و چالشهای توالییابی خوانش بلند
با وجود قابلیتهای گسترده، Long-read Sequencing بدون محدودیت نیست.
- هزینه اجرای پروژه: هزینه نهایی به دستگاه، مواد مصرفی، تعداد نمونهها، عمق توالییابی و خدمات تحلیل داده وابسته است.
- کیفیت و یکپارچگی DNA: DNA تخریبشده یا قطعهقطعهشده میتواند طول خوانشها را کاهش دهد و بر کیفیت نتیجه اثر بگذارد.
- نیاز به تحلیل بیوانفورماتیکی: دادهها به ابزارهای مناسب برای کنترل کیفیت، همترازی، شناسایی واریانتها و تفسیر نتایج نیاز دارند.
- تفاوت دقت میان پلتفرمها: دقت خوانش به فناوری، شیمی دستگاه، نوع مولکول، الگوریتم پایهخوانی و روش اجماعسازی بستگی دارد.
- نیاز به طراحی صحیح آزمایش: انتخاب طول قطعه، عمق توالییابی، نوع کتابخانه و روش تحلیل باید متناسب با سؤال پژوهش انجام شود.
طولانیتر بودن خوانش بهتنهایی تضمینکننده نتیجه بهتر در تمام پروژهها نیست. پیش از انتخاب فناوری باید مشخص شود که اطلاعات اضافهای که خوانش بلند فراهم میکند، ارزش هزینه و پیچیدگی احتمالی بیشتر را دارد یا خیر.
آینده Long-read Sequencing در بیوتکنولوژی و ژنومیک
با پیشرفت فناوریهای توالییابی و ابزارهای تحلیل داده، انتظار میرود Long-read Sequencing نقش مهمتری در مطالعه ژنومهای پیچیده، تحلیل رونوشتها و پژوهشهای چنداُمیکی ایفا کند.
یکی از مسیرهای مهم توسعه، ترکیب اطلاعات ژنومی با دادههای اپیژنتیکی و ترنسکریپتومی است. چنین رویکردی به پژوهشگران کمک میکند ارتباط میان ساختار DNA، تنظیم بیان ژن و عملکرد سلولی را بهتر بررسی کنند.
بهبود الگوریتمهای بیوانفورماتیک و روشهای شناسایی واریانت نیز میتواند به تحلیل دقیقتر دادهها کمک کند. در پژوهشهای بیماریهای ژنتیکی و سرطان، این فناوری ظرفیت دارد اطلاعات بیشتری درباره تغییرات ساختاری و مولکولی فراهم کند؛ هرچند کاربرد بالینی آن به مطالعات اعتبارسنجی و ارزیابی بالینی نیاز دارد.
برای دانشجویان زیستشناسی، ژنتیک، بیوتکنولوژی و بیوانفورماتیک، یادگیری اصول توالییابی خوانش بلند میتواند زمینهای مناسب برای ورود به پروژههای پیشرفته ژنومیک و تحلیل دادههای زیستی فراهم کند.
جمعبندی
Long-read Sequencing یکی از فناوریهای مهم در ژنومیک مدرن است که با امکان خواندن قطعات طولانی DNA و RNA، به پژوهشگران کمک میکند بخشهایی از اطلاعات ژنتیکی را که بررسی آنها با روشهای مبتنی بر خوانش کوتاه دشوار است، بهتر مطالعه کنند.
از شناسایی تغییرات ساختاری ژنوم و بررسی بیماریهای ارثی گرفته تا تحقیقات سرطان، مونتاژ ژنوم، تحلیل ایزوفرمهای RNA و مطالعات اپیژنتیک، این فناوری فرصتهای تازهای برای شناخت سازوکارهای زیستی فراهم کرده است.
با این حال، انتخاب میان Long-read Sequencing و Short-read Sequencing باید براساس هدف آزمایش، ویژگی نمونه، دقت مورد نیاز، هزینه و امکانات تحلیل داده انجام شود.
در بیونوین، آشنایی با فناوریهای نوین زیستشناسی مولکولی و روشهای پیشرفته تحلیل ژنتیکی، فرصتی برای گسترش دانش تخصصی و شناخت مسیرهای جدید پژوهش در علوم زیستی است.
دوره های آموزشی بیونوین
03136698101
09900043193
پیج اینستاگرام زیست فناوری نوین
سؤالات متداول درباره Long-read Sequencing
۱. تفاوت اصلی Long-read Sequencing و Short-read Sequencing چیست؟
تفاوت اصلی در طول خوانشهاست. Long-read Sequencing قطعات طولانیتری از DNA یا RNA را میخواند و برای بررسی نواحی تکراری، تغییرات ساختاری و رونوشتهای پیچیده مزیت دارد؛ درحالیکه Short-read Sequencing برای بسیاری از پروژههای پرظرفیت گزینهای کارآمد است.
۲. مهمترین فناوریهای Long-read Sequencing کداماند؟
دو فناوری شناختهشده عبارتاند از PacBio SMRT Sequencing و Oxford Nanopore Sequencing. فناوری PacBio HiFi با خواندن چندباره مولکول الگو، توالیهای اجماعی با دقت بالا تولید میکند؛ در مقابل، Oxford Nanopore توالی را با تحلیل سیگنالهای الکتریکی حاصل از عبور مولکول از نانوحفره تعیین میکند.
۳. آیا Long-read Sequencing در تحقیقات سرطان کاربرد دارد؟
بله. این فناوری در پژوهشهای سرطان برای بررسی تغییرات ساختاری ژنوم، برخی ژنهای فیوژن، الگوهای متیلاسیون و ایزوفرمهای RNA کاربرد دارد. استفاده تشخیصی یا درمانی از نتایج آن به شواهد و اعتبارسنجی متناسب با کاربرد مورد نظر نیاز دارد.
۴. آیا برای انجام Long-read Sequencing به بیوانفورماتیک نیاز داریم؟
بله. تحلیل دادههای توالییابی معمولاً به ابزارهای بیوانفورماتیکی برای کنترل کیفیت، همترازی توالیها، شناسایی واریانتها و تفسیر نتایج نیاز دارد.
۵. آیا Long-read Sequencing همیشه دقیقتر از Short-read Sequencing است؟
خیر. دقت به پلتفرم، نوع خوانش، کیفیت نمونه و روش تحلیل وابسته است. بعضی فناوریهای خوانش بلند مانند PacBio HiFi دقت بسیار بالایی دارند، اما برتری هر روش باید برای کاربرد مشخص ارزیابی شود.